
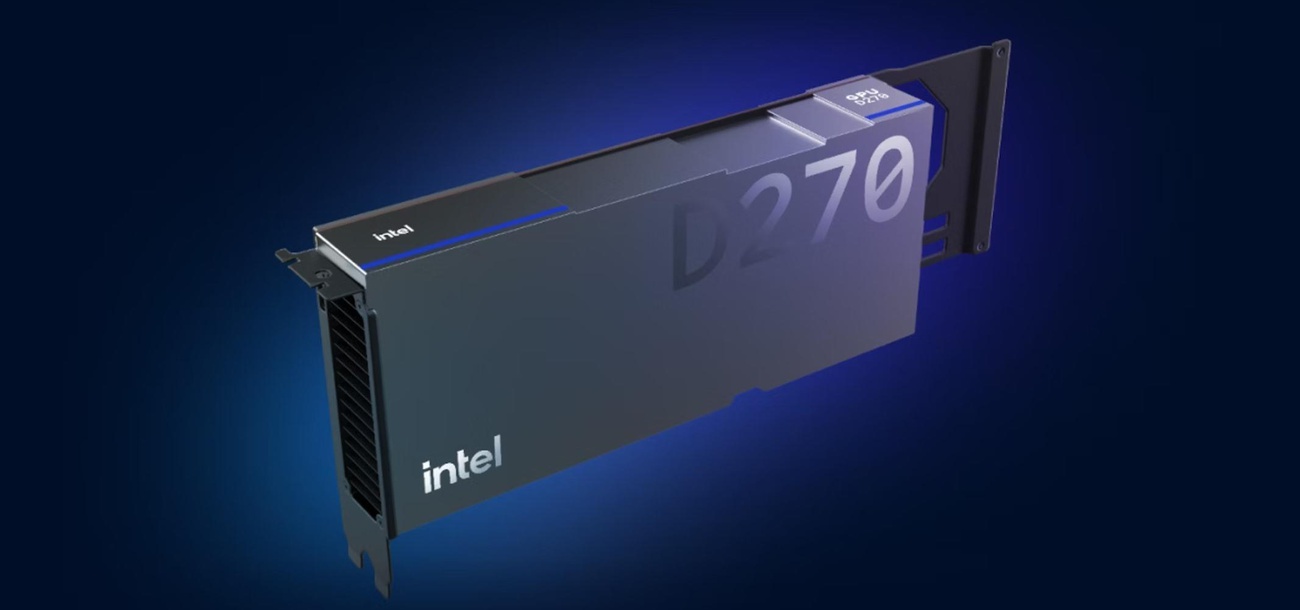

Компания Intel опубликовала результаты тестов своего серверного ускорителя GPU D270 (Crescent Island) на архитектуре Xe3P. В задачах оценки опционов он оказался быстрее NVIDIA RTX PRO 6000 в 1,92–5,9 раза, хотя потребляет не больше 350 Вт.
Сравнение проводилось на четырех моделях ценообразования опционов: методом Монте-Карло для американских и европейских опционов, биномиальной моделью и классической моделью Блэка — Шоулза для европейского рынка. Разница между двумя типами в том, что европейский опцион нельзя исполнить досрочно, до истечения срока.
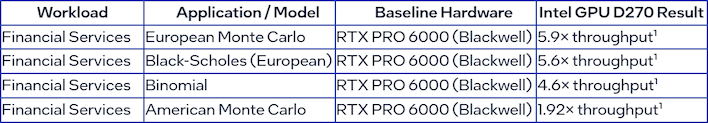
Максимальное преимущество в 5,9 раза Intel получила в симуляции Монте-Карло для европейских опционов. Скромнее всего результат в симуляции для американских опционов: D270 «всего» в 1,92 раза быстрее.
По словам Intel, такой отрыв объясняется двумя причинами:
Xe3P выполняет вычисления двойной точности (FP64) на полной скорости, тогда как у GPU NVIDIA производительность в FP64 сильно падает;
у D270 на две трети больше памяти: 160 ГБ LPDDR5X против 96 ГБ GDDR7 у RTX PRO 6000.
Энергопотребление при этом тоже в пользу Intel: ее карта ограничена 350 Вт, а гораздо более крупный по вычислительным ресурсам GPU NVIDIA может потреблять до 600 Вт. Впрочем, трюк знакомый: AMD уже сравнивала свои Ryzen AI Max с большими видеокартами NVIDIA, выбирая задачи, где выигрывает объем памяти. Здесь к памяти добавляется еще и то, что D270 спроектирован под задачи, для которых RTX PRO 6000 изначально не предназначалась.
Сейсмическая разведка
Второй пример касается не скорости, а простоты переноса кода. Партнер Intel, компания Viridien, которая занимается данными о недрах Земли, перенесла свое мини-приложение для сейсмической визуализации на GPU D270 «менее чем за месяц» и «без изменений кода на стороне хоста», сохранив точность вычислений и «производительность». Какую именно производительность удалось получить, Intel не уточняет.
ИИ
RTX PRO 6000 создавалась в первую очередь для ИИ, но и здесь Intel заявляет преимущество. По данным компании, D270 на 29% быстрее по задержке принятия решений в агентных ИИ-системах, а при одинаковом ограничении мощности в 350 Вт выдает на 12% большую пропускную способность при работе с LLM. Последнее сравнение, по сути, признает, что на полной мощности решение NVIDIA заметно быстрее.
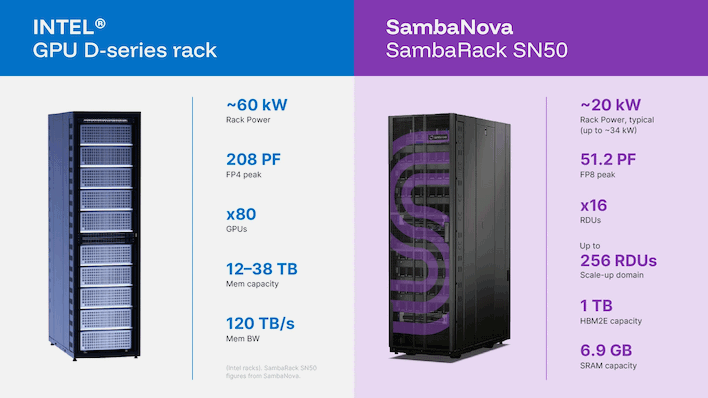
Для HPC-лабораторий, использующих ИИ-инструменты, Intel предлагает гибридную систему: реконфигурируемые потоковые процессоры SambaNova SN50 RDU, ускорители GPU D270 и процессоры Xeon 6(+). Задачи разного типа распределяются между ними, чтобы «ускорить весь агентный цикл». Отдельно Intel подчеркивает, что вся конструкция обходится воздушным охлаждением, без дорогой инфраструктуры жидкостного.
Связку GPU D270 и SN50 Intel показывает на конференции SC26 в Чикаго, которая идет всю эту неделю. Стоит помнить, что все цифры пока исходят от самой Intel, и независимых тестов D270 еще нет.
Источник: Hot Hardware


Комментарии
Войдите на сайт, чтобы оставить свой комментарий...